GPT-6 AstraをAGIと判定したJevの仕組み
🔔 主要報道:The Register/TypeSafe AI公式ブログ
Jevの中身
ChatGPTを作った本人が「対話モデルはAGIへの回り道だった」と行動で示した中身を見ていこう。
ChatGPTの生みの親が2年間のステルスを解いた
Diogo Almeida氏は元OpenAIリサーチャーで、ChatGPTを人間の指示に従うよう訓練したRLHF(人間フィードバックによる強化学習)の共同発明者の一人だ。9月15日、自身が創業したTypeSafe AIから「Jev」を発表した。「ChatGPTを共同発明した後、なぜ超人的なチャットモデルがAGIにつながっていないのか、ずっと自問自答していた」という投稿とともに、2年間かけて開発した新しい訓練手法「RLCD(Reinforcement Learning for Calibrated Decisions)」による新種のモデルを公開している。共同創業者には元Meta・FAIRのSasha Sheng氏、ゲノムAIスタートアップ出身のErik Gafni氏が名を連ね、DCVC主導で4000万ドルのシード資金を調達済みだ。
文章を生成しない「System One Model」という新カテゴリ
Jevは通常のLLMのように文章をトークンごとに生成しない。あらかじめ定義した選択肢のリストと状態(メール・ログ・チケットなど)を渡すと、選択・スコア・確率のいずれかを、確信度の数値付きで一括して返す仕組みだ。TypeSafeはこれを心理学者ダニエル・カーネマンの「システム1」思考になぞらえ、直感的な判断に特化したモデルと位置づけている。文章を生成しない分、外部仕様から外れた出力そのものが起きない設計になっている。
謳い文句は20〜200倍速く、40〜400倍安い
TypeSafeは、既存LLMをジャッジや分類・ルーティングの用途に使う場合と比べて、Jevは20〜200倍速く、40〜400倍安いと主張している。応答時間はおよそ70〜500ミリ秒、価格は入力100万トークンあたり0.042ドルで出力は無料だ。ただしモデルの重みは非公開で、早期アクセスの順番待ちリストに登録する形での提供となっている。ベンチマーク数値は今のところ、TypeSafe自身が公開した資料以外に第三者による検証は出ていない。
【著者が整理】Jevのコストを試算
「40〜400倍安い」という数字を、分類・ルーティング特化の既存モデルと比べてみた。
TypeSafeが比較対象にしているのは、汎用LLMをジャッジや分類に流用した場合の価格だ。分類・抽出・ルーティング専用に設計された低価格モデルと比べると、差はもっと縮まる。GPT-5.4 nano(入力100万トークンあたり0.20ドル)と比べると約4.8倍、Claude Haiku 4.5(同1.00ドル)と比べると約24倍という結果になった。どちらもTypeSafeが掲げる「40〜400倍」には届かない。
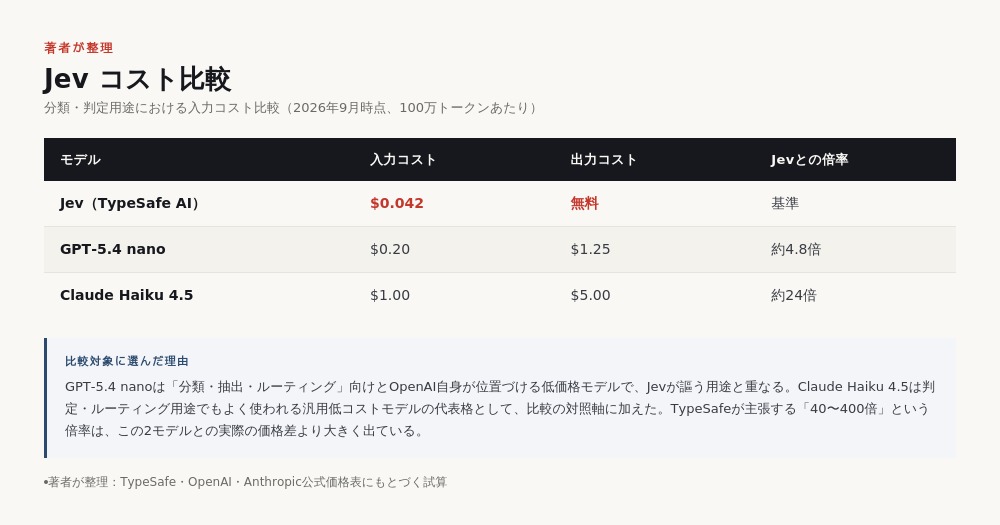
著者が整理:TypeSafe・OpenAI・Anthropic公式価格表にもとづく試算(2026年9月時点)
比較対象に選んだ理由
GPT-5.4 nanoを比較対象に選んだのは、OpenAI自身が「分類・抽出・ルーティング」向けと位置づける低価格モデルで、Jevが想定する用途と重なるためだ。Claude Haiku 4.5は、判定・ルーティング用途でもよく使われる汎用低コストモデルの代表格として、対照軸に加えた。同じ「安さ」を売りにするモデル同士で比べることで、TypeSafeの主張する倍率がどこまで実態に即しているかが見えてくる。
両論評価
Jevの発想を評価する見方と、実証段階に懐疑的な向き、双方の論拠を整理する。
▶ 評価する側:実際の精度を反映する形で確信度スコアを訓練するRLCDという方向性は有望だ。文章生成を捨てて判定に特化することで、構造上ハルシネーション(存在しない回答)が起きない設計になっている点も、コードから呼び出す用途では実用的な強みになる。
▶ 懐疑的な側:ベンチマークの数字は現時点でTypeSafe自身の発表資料にしかなく、モデルの重みも研究論文も公開されていない。「ハルシネーションが起きない」というのは形式から外れた出力をしないという意味であって、判定の中身が正しいことまでは保証していない。
確信度スコアが実際のタスクでどこまで正確にキャリブレーションされているかは、開発者が自分のデータを持ち込んで検証するまで分からない部分が大きい。
日本の企業・産業への影響まとめ
- ① 判定・分類コストの構造が変わる可能性がある:コンテンツモデレーションやルーティングなど大量の判定処理を抱えるサービスは、コスト構造が今後変わる可能性を継続してチェックしよう
- ② 早期アクセス段階であることは踏まえておきたい:閉鎖ウェイトで第三者検証がまだない段階のため、本番導入の判断は独立した検証結果が出揃ってからでも遅くないと思う
では実務としてどうするか。判定・分類系のワークロードを持つ企業は、まず自社のタスクで確信度スコアがどれだけ実態と一致するかを小規模に検証する価値がありそうだ。早期アクセスの申し込みと並行して、既存の低価格モデル(GPT-5.4 nanoやHaiku 4.5など)との精度・コスト比較を自分たちのデータで一度試しておくと、判断材料が揃う。
※本記事は2026年9月15日時点の公式発表にもとづく分析です。情勢は今後変化する可能性があります。判断は必ず最新の公式発表をご確認ください。
Jevとは何か。
ChatGPTの生みの親の一人、Diogo Almeida氏が創業したTypeSafe AIが9月15日に発表した新種のAIモデル。文章を生成せず、事前に定義した選択肢から判定だけを返す「System One Model」というカテゴリで、独自の訓練手法RLCDを使っている。
Jevは既存のLLMよりどれくらい安いのか。
TypeSafeは既存LLMをジャッジや分類に使う場合と比べて20〜200倍速く、40〜400倍安いと謳っている。著者の試算では、分類・ルーティング向けの低価格モデルGPT-5.4 nanoと比べて約4.8倍、Claude Haiku 4.5と比べて約24倍の価格差だった。TypeSafeの主張する倍率より実際の差は小さい。
GPT-6 AstraをAGIと判定した投票は公式な評価なのか。
公式なベンチマークではない。エンジニアの一人がJevのデモとして、どのモデルがAGIかを判定させたところGPT-6 Astraが69%を占めたというもので、確信度は63%だった。Jevの実演例として話題になったが、厳密な評価指標として扱う性質のものではない。