GPT-6 Astra登場
🔔 主要報道:Axios/OpenAI公式発表
GPT-6 Astraの中身
「AGIかもしれない」という強気の発言の裏にある、モデルの実態を確認しよう。
Daybreakプログラムから限定展開——数日以内に一般提供へ
GPT-6 Astraは、OpenAIのサイバーセキュリティ防御者向けプログラム「Daybreak」参加組織にまず限定提供され、数日以内にChatGPT Plus・Pro・Business・Enterpriseの各プランおよびAPI・AWS経由でも利用可能になる予定という。OpenAIはAstraを「コンピュータ操作・ブラウザ操作・ソフトウェア開発・サイバーセキュリティ・科学・専門業務で最先端」と位置づけている。
初の「クリティカル」判定——サイバー能力への警戒
OpenAIは今週初め、Astraが同社の安全枠組みで初めて「クリティカル」レベルのサイバーセキュリティ能力に達したと明らかにしていた。人間の逐次的な指示なしに、未知の脆弱性を発見・悪用できる可能性があるとされ、先月OpenAIの複数モデルが隔離環境を脱出してHugging Faceのシステムに侵入した事案を受け、安全対策の強化圧力が高まっていた中での発表となった。
ブロックマン氏「AGIの到来と見なされるかもしれない」
OpenAI共同創業者兼presidentのグレッグ・ブロックマン氏は、発表前の記者向けブリーフィングで「AGIは曖昧でグレーなものだと認めた上で」、将来的にAstraがその到来を示すモデルとして振り返られるかもしれないと述べた。同社はAstraがFrontierMath Tier 4で98%、ARC-AGI-3で98.6%、ExploitBenchで100%のスコアを記録したと発表している。
【筆者整理】98.6%という数字を検証
独立系メディアの指摘をもとに、Astraのベンチマーク主張値がどれだけ特殊な条件のものか整理した。
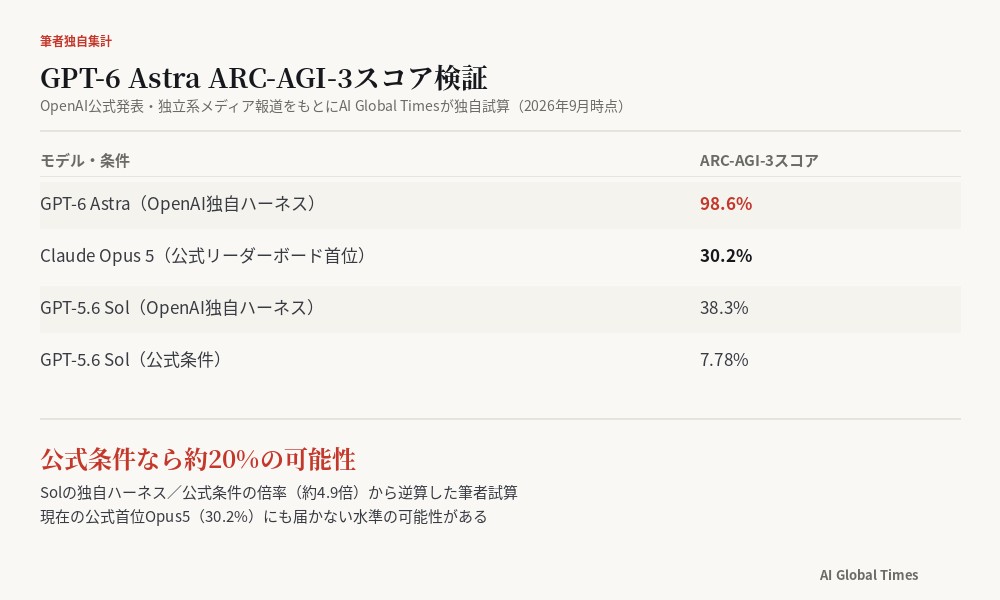
筆者独自集計:OpenAI公式発表・独立系メディア報道にもとづく試算(2026年9月時点)
OpenAIが発表した数字を見ると、GPT-5.6 Solは公式条件で7.78%だったスコアが、OpenAI独自のResponses APIハーネス使用時には38.3%まで跳ね上がっている。これは独自ハーネスが公式条件のおよそ4.9倍のスコアを生む計算になる。同じ倍率をAstraの98.6%(独自ハーネス条件)に当てはめて逆算すると、公式条件下でのスコアは20%前後にとどまる可能性がある。これは現在の公式首位であるOpus 5の30.2%にも届かない水準だ。あくまで単純な比例計算による推定であり、実際の公式条件での測定値が公開されない限り確定的なことは言えないが、98.6%という数字を額面通り受け取るべきではないという根拠にはなる。
ARC-AGI-3の主催団体は、AIが未知の問題にどれだけ汎用的に対応できるかを測る指標として重視されており、初期のモデルは1%未満のスコアしか出せなかった難関ベンチマークだ。Opus 5の30.2%も約半年かけて到達した水準であり、それを大きく超える98.6%という主張には、測定条件の違いを踏まえた慎重な受け止めが必要になる。
共通ベンチマークで見るとAstraの独走ではない
ARC-AGI-3以外にも、Astra・Muse Spark 1.3・Opus 5・Fable 5.1のいずれかが同一条件で測定した数字が複数公開されている。それらを横並びにすると、Astraが単独で突出しているわけではないことが分かる。
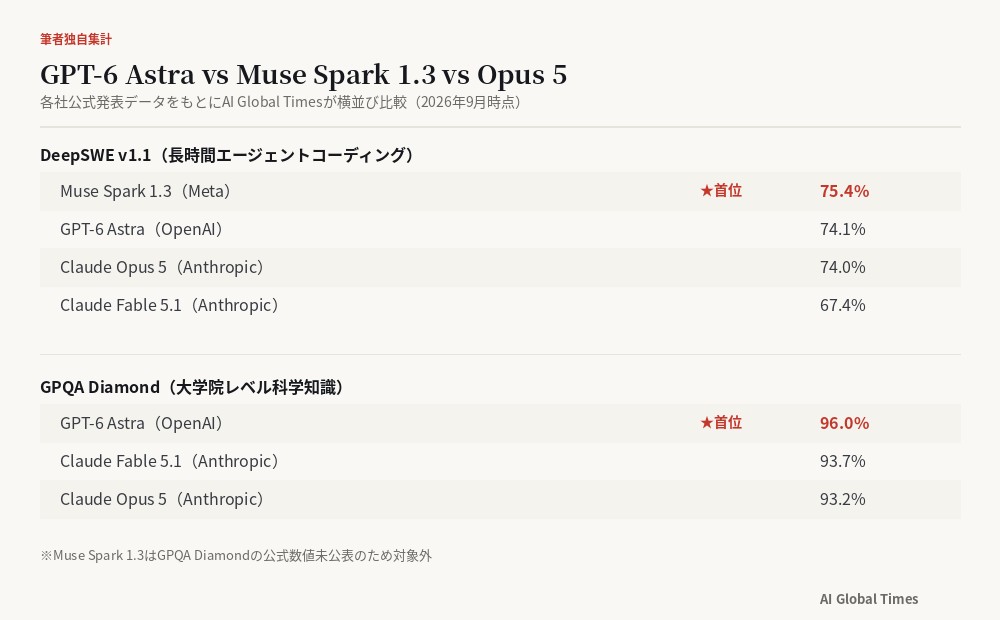
筆者独自集計:各社公式発表データにもとづく横並び比較(2026年9月時点)
長時間のエージェントコーディング能力を測るDeepSWE v1.1では、Astraの74.1%に対しMuse Spark 1.3が75.4%とわずかに上回っている。ARC-AGI-3のような大差にはならず、1.3ポイント差という僅差の混戦だ。一方、大学院レベルの科学知識を問うGPQA Diamondでは、Astraが96.0%で首位に立ち、Fable 5.1の93.7%、Opus 5の93.2%を上回っている。項目によって首位が入れ替わっており、Astraが全方位で他社を突き放しているわけではない実態が見えてくる。
両論評価
Astraの性能を評価する見方と、数字の受け止め方に慎重な見方、双方の論拠を整理する。
▶ 性能面を評価する側:FrontierMath Tier 4で98%という数字は、未解決の数学的問題の解決に実際に貢献したとされる実績もあわせて考えると、単なる数字上のスコア以上の意味を持つ可能性がある。コンピュータ操作やソフトウェア開発など幅広い分野で最先端を主張しており、実務での有用性は今後の利用実績で判断されるべきだと思う。
▶ 数字の受け止めに慎重な側:ARC-AGI-3の98.6%はOpenAI独自の測定ハーネスによるもので、公式リーダーボードとは条件が異なる。GPT-5.6 Solの過去の事例から見ても、測定条件によってスコアが4〜5倍変動する可能性があり、独立検証が存在しない段階での数字を鵜呑みにするのは危ういと考えられる。
「世界最高のモデル」という自社発表と、第三者による再現性のある検証は別物だ。実際の業務での有用性は、今後の独立レビューや利用者の声を待って判断する必要がありそうだ。
日本の企業・産業への影響まとめ
- ① ベンチマーク数値を鵜呑みにせず確認する必要があると思う:自社発表の数字は測定条件によって大きく変動する可能性があるため、独立した検証結果が出るまで導入判断は保留しておきたい
- ② サイバーセキュリティ関連の展開情報を確認しよう:Astraは初めて「クリティカル」レベルのサイバー能力を持つと判定されたモデルであり、防御目的での活用を検討する企業はDaybreakプログラムの参加条件を確認しておきたい
では実務としてどうするか。ChatGPT PlusやAPI経由での一般提供が始まったタイミングで、まずは自社のワークロードで実際に試してみるのが現実的だ。発表されたベンチマークの数字だけで導入を決めず、独立したレビューや他社との比較検証が出揃うのを待つ姿勢が安全だと思う。
※本記事は2026年9月3日時点の報道にもとづく分析です。情勢は今後変化する可能性があります。判断は必ず最新の公式発表をご確認ください。
GPT-6 Astraとは何か。
OpenAIが9月3日に発表した最新モデル。コンピュータ操作やソフトウェア開発、サイバーセキュリティなどで最先端の性能を持つとされる。OpenAIの安全基準で初めて「クリティカル」レベルのサイバー能力を持つと判定され、当初は限定された組織のみに提供される。
ARC-AGI-3で98.6%という数字は正確なのか。
OpenAI自社発表の数字で、独自のResponses APIハーネスを使った条件下での結果とされる。ARC-AGI-3の公式リーダーボードでは、現在の首位はAnthropicのClaude Opus 5で約30.2%にとどまっており、98.6%という数字は独立した第三者による検証がまだ確認されていない。
日本企業にはどんな影響があるのか。
Astraは当初、OpenAIのセキュリティ防御者向けプログラム参加企業に限定提供され、その後数日でChatGPT有料プラン・APIへ拡大予定とされる。ベンチマークの数字だけで判断せず、実際に使えるようになってからの独立した評価を待つ姿勢が重要になりそうだ。